Prever a mesclagem de pull requests do Node.js com aprendizado de máquina

Neste artigo, explicarei um uso simples do aprendizado de máquina (ML) para avaliar se é possível prever com precisão a aceitação de um pull request (PR) ao criá-lo. O experimento busca gerar um programa confiável que ajude o integrador a gerenciá-los em um projeto. Como projetos grandes recebem PRs continuamente, exploramos um modelo replicável para filtrar rapidamente os indesejados.
Os trabalhos de Yu et al.1 e Gousios et al.2 propõem modelos treinados com vários repositórios para prever a aceitação até em projetos diferentes. Isso reduz a acurácia, especialmente ao treinar com projetos A e B e prever em C, cujos critérios podem ser diferentes. Nossa abordagem usa apenas dados do mesmo projeto. Prevemos PRs do Nodejs com dados disponíveis ao enviá-los para avaliar imediatamente se serão mesclados.
Construir o preditor
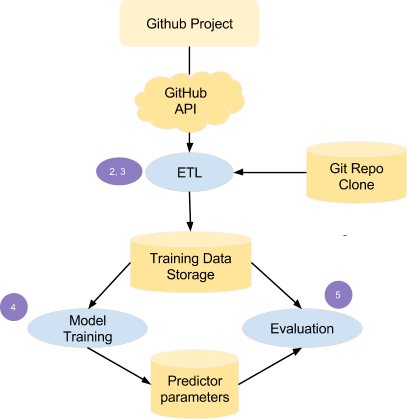
Precisamos criar um preditor e encontrar os parâmetros adequados. Seguimos estes passos:
- Definir características relevantes para avaliar um PR.
- Coletar dados das fontes do GitHub do projeto.
- Normalizar os dados em um armazenamento persistente para modelos ML.
- Escolher o modelo que funciona melhor com os dados.
- Avaliar o preditor em um conjunto separado.
Definir características
No passo 1, baseamo-nos em Yu et al. e usamos estas características:
description_complexity
|
Número de palavras na descrição e no título. Uma descrição maior pode indicar um PR complexo com muitas funcionalidades, mais difícil de aprovar. |
log_hotness
|
Refere-se ao número H de atividade da área do projeto: arquivos modificados nos últimos 3 meses que também estão no PR. Assume o valor log(1 + H). Uma atividade maior pode indicar PRs demais afetando arquivos centrais e gerando controvérsia.
|
log_churn
|
Refere-se ao volume de mudanças do PR C: soma de linhas excluídas, modificadas e adicionadas. Assume o valor log(1 + H).
|
is_integrator
|
Indica se o autor é integrador: alguém que mesclou um PR ao menos uma vez na história do projeto. Seus PRs têm mais chance de sucesso. Vale 1 ou 0 conforme seja integrador. |
has_tests
|
Indica se o PR inclui testes, o que pode favorecer a aprovação. Vale 1 ou 0 conforme tenha testes. É determinado comparando o nome de cada arquivo adicionado ou modificado com expressões regulares para identificar testes. |
success_rate
|
Número relacionado à aceitação anterior dos PRs do autor: proporção entre aprovados e enviados. Uma taxa maior pode indicar aceitação. |
social_conn
|
Soma de seguidores e seguidos do autor. Mais conexões sociais podem indicar maior sucesso. |
requested_reviewers
|
Indica se o autor solicitou revisores. Sugere interesse na aceitação do PR. Incluir um revisor pode aumentar a chance de aceitação. |
created_friday
|
Solicitações criadas na sexta-feira têm mais chance de não ser aceitas ou de ser aceitas mais tarde pelo fim de semana, aumentando a fila de PRs. |
No futuro, poderíamos incluir cumprimento de requisitos de mensagens de commit, testes unitários aprovados ou número de PRs abertos. Também dados cronológicos: requisitos mudam, e um PR antigo é avaliado por padrões diferentes. Classificar dados temporais é um problema comum em ML porque critérios dependem de quando foram criados e classificados. Brownlee3 mostra uma forma de lidar com previsões.
Carga ETL
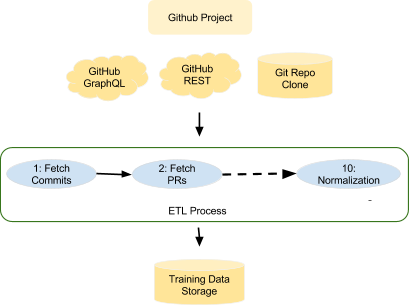
Diagrama do processo ETL
Os passos 2 e 3 usam extração, transformação e carga (ETL), que consome a API do GitHub REST (V3), tanto REST quanto GraphQL, e salva características no MongoDB. Recupera dados dos PRs pela API. Para calcular volume de mudanças e atividade, usamos um clone do repositório e um cliente git para comparar branches de origem e destino. A API GraphQL (V4) obtém informações de usuários, incluindo conexões sociais (social_conn). Permite consultas mais ricas entre entidades, como conexões de todos os autores, e reduz solicitações URL. Este código obtém dados paginados de MergedEvents de um PR para detectar se foi mesclado.
{
 repository(owner: nodejs, name: node){
   name,
   pullRequests(first: 100, states: MERGED) {
     nodes {
       id,
       url,
       timeline(last: 100) {
         nodes {
             ... on MergedEvent {
            id,
             actor {
               login
             }
             createdAt,
             url,
           }
         }
       }
     },
     pageInfo {
       hasNextPage,
       hasPreviousPage,
       endCursor,
       startCursor,
     },
     totalCount
   }
  }
}
Não pudemos usar GraphQL em todos os casos por limites menores de solicitações, que tornam a recuperação mais lenta. Chamadas complexas também foram mais lentas que equivalentes V3. Projetamos ETL para ser retomado e reiniciado, pois pode levar horas. Dividimos nestas tarefas:
| 1 | fetchCommits
|
Obtém todos os commits da branch master pela API REST |
| 2 | fetchPullRequests
|
Obtém os metadados de todos os PRs pela API REST |
| 3 | fetchCommitDiffs
|
Clona localmente o repositório git e as branches de origem dos PRs para calcular atividade e volume de mudanças |
| 4 | fetchUserEvents
|
Salva eventos recentes do usuário para calcular conexões sociais. Não foi usado no conjunto final de características. |
| 5 | fetchUserInfo
|
Obtém metadados de usuário pela API GraphQL |
| 6 | fetchIntegrators
|
Obtém os integradores consultando MergedEvents do pull request |
| 7 | computeHotness
|
Usa o repositório local para comparar as branches de origem e destino do PR e calcular |
| 8 | guessCommitPRRefs
|
Deduz eventos de mesclagem pelo histórico. É específico do NodeJS, que fecha PRs e os mescla em um commit separado em vez de usar a função do GitHub. |
| 9 | setUsersId
|
Decodifica informações de usuário em base64 para relacionar dados de PRs e usuários. |
| 10 | Normalization
|
Combina os dados para gerar informações prontas para treinamento: uma tabela de características e classificação (mesclado/não mesclado) |
Tarefas ETL para carregar e normalizar dados
Construção e avaliação do preditor
Sobreajuste de precedentes eleitorais (fonte: XKCD)
Com os dados prontos, os passos 4 e 5 usam scikit-learn. Para evitar sobreajuste, dividimos em treinamento e validação: 90% dos PRs para treinar e 10% para validar. Fazemos validação cruzada dividindo o treinamento em 10 grupos com k-fold. Testamos estes preditores:
- Naive Bayes (Bernoulli e gaussiano)
- Árvores de decisão
- K vizinhos mais próximos
- Análise discriminante linear
- Regressão logística
- Perceptrons multicamadas
- Centroides mais próximos
- Análise discriminante quadrática
- Regressão Ridge
- Máquinas de vetores de suporte (SVC), com suporte C e lineares
- Descida de gradiente estocástico (SGD)
- Algoritmos passivo-agressivos
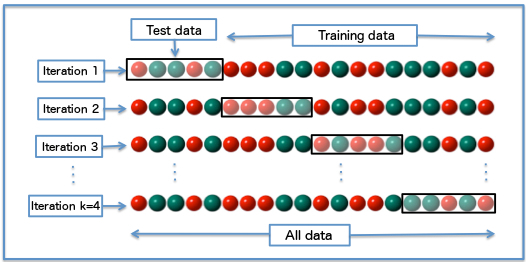
Diagrama de validação k-fold com 4 grupos (fonte: Wikipedia)

Coletamos 10,200 PRs do repositório nodejs entre novembro de 2014 e novembro de 2017. Os dados brutos tinham esta forma. Cerca de 76% dos MRs recuperados foram mesclados; é um conjunto considerável para treinar a maioria dos preditores.
created_
friday
|
description_
complexity
|
log_hotness
|
log_churn
|
is_integrator
|
|
| Média | 0.172 |
134.500 |
1.147 |
5.944 |
0.498 |
| Desvio padrão | 0.377 |
389.832 |
0.915 |
3.901 |
0.500 |
| Mín. | 0.000 |
1.000 |
0.000 |
0.000 |
0.000 |
| Máx. | 1.000 |
19,825.000 |
4.043 |
15.523 |
1.000 |
| Análise de dados de PRs | |||||||
has_tests
|
success_rate
|
social_conn
|
requested_review
|
was_merged
|
|||
| Média | 0.721 |
0.514 |
4.973 |
0.019 |
0.758 |
||
| Desvio padrão | 0.448 |
0.221 |
1.801 |
0.138 |
0.428 |
||
| Mín. | 0.000 |
0.000 |
0.000 |
0.000 |
0.000 |
||
| Máx. | 1.000 |
1.000 |
11.823 |
1.000 |
1.000 |
||
Testamos 21 classificadores e obtivemos acurácia de 77% a 88% no treinamento. Escolhemos SVC com suporte C, com média de 87% em 10 validações cruzadas. É bom para treinamento, mas a avaliação real usa dados de teste. Ali, alcançou precisão um pouco menor, de 78%, ainda aceitável.
| Precisão | Revocação | Pontuação F1 | Suporte | |
| Não mesclado | 0.76 |
0.22 |
0.34 |
264 |
| Mesclado | 0.78 |
0.98 |
0.87 |
753 |
| Média | 0.78 |
0.78 |
0.73 |
1017 |
Métricas de precisão sobre dados de teste
Conclusões e melhorias futuras
Os experimentos mostram que podemos prever MRs com acurácia e aliviar a carga dos integradores diante de grandes filas. Dados temporais exigem tratamento especial: critérios mudam, e talvez convenha filtrar MRs antigos. Mais características melhorarão as previsões. Extrair dados do GitHub pode demorar e exige lidar com desconexões e limites da API para recuperar o processo. Cada projeto também tem mecanismos diferentes de mesclagem, às vezes sem a função “merge” do GitHub, e pode exigir CI para aceitar um MR. Isso precisa ser considerado. Não há solução universal, mas com ferramentas adequadas pode-se criar uma aplicação preditora para cada projeto com MRs suficientes. O código está em https://github.com/sophilabs/pullreq-ml.
Referências
-
Y. Yu, H. Wang, V. Filkov, P. Devanbu e B. Vasilescu, “Espere: fatores de latência na avaliação de pull requests no GitHub”, 2015 IEEE/ACM 12th Working Conference on Mining Software Repositories, Florença, 2015, pp. 367-371. ↩
-
Gousios, Georgios e Pinzger, Martin e Deursen, Arie van, “Estudo exploratório do modelo de desenvolvimento de software baseado em pull requests”, Proceedings of the 36th International Conference on Software Engineering, pp. 345-355 ↩
-
Jason Brownlee, Como converter uma série temporal em um problema de aprendizado supervisionado no Python, consultado em machinemastery.com, 8 de maio de 2017. ↩