Automatizar el procesamiento de facturas: la parte difícil no es leer la factura
Todos los equipos de cuentas por pagar tienen el mismo tipo de problema. Las facturas llegan en todos los formatos que pueda inventar un proveedor —PDF, escaneos, fotos de papel, correos con el importe en el cuerpo— y alguien las ingresa en el sistema, las coteja con una orden de compra, da seguimiento a las que no coinciden y consigue las aprobaciones. Ingresar los datos es aburrido. La validación es donde se pierde dinero: duplicados, impuestos incorrectos, condiciones que nadie leyó o un proveedor cuyos datos bancarios cambiaron el mes pasado.
Por eso, cuando una empresa dice que quiere «automatizar las facturas», normalmente se refiere al ingreso de datos. La parte que vale la pena automatizar es la validación.
La lectura está suficientemente resuelta
Los modelos de documentos que reconocen la disposición de la página ya pueden leer una factura que nunca han visto y devolver campos estructurados: proveedor, fechas, conceptos, impuestos, totales y condiciones de pago. Manejan los formatos desordenados que antes superaban al OCR basado en plantillas, y los analizadores de código abierto son lo suficientemente buenos como para que el modelo rara vez sea la limitación.
Esa es la mitad fácil. Una extracción correcta el 95% de las veces todavía deja una de cada veinte facturas con errores, sin forma de saber cuál.
El sistema que realmente da resultados
El diseño útil tiene cuatro partes, y solo la primera trata sobre leer.
1. Extrae y luego valida con tus propios datos. Un campo no es «correcto» porque el modelo tenga confianza, sino porque coincide con algo que ya sabes. ¿Existe la orden de compra y sigue abierta? ¿Coincide el proveedor con el registro maestro, incluidos los datos bancarios? ¿Ya apareció este número de factura? ¿La suma de los conceptos coincide con el total? La validación convierte la extracción en evidencia.
2. Deriva según la confianza, no según una regla. Cada factura recibe una puntuación que combina la extracción y la validación, y esa puntuación determina quién la ve:
- Confianza alta, todo coincide: pasa directamente a la aprobación y al libro contable. Ninguna persona interviene.
- Media: un campo no coincide o el modelo no estaba seguro. Un revisor ve el documento y los campos extraídos uno al lado del otro y corrige un dato con un clic.
- Baja o anómala: proveedor nuevo, datos bancarios cambiados o un importe muy alejado del rango habitual. Revisión completa, por diseño.
El objetivo no es eliminar toda revisión. Es reservarla para lo que requiere criterio.
3. Haz que la revisión sea rápida y que sirva para aprender. La pantalla de revisión es el producto que realmente usa el equipo de finanzas, así que merece ser buena: el original de un lado, los campos del otro, correcciones con un clic y un botón «aprobar» claro. Cada corrección se registra y se incorpora como retroalimentación —un formato extraño de un proveedor, un error de lectura recurrente— para no repetir el mismo error. La cola se acorta cada mes, y esa reducción es la métrica.
4. Genera acciones, no una hoja de cálculo. Una factura procesada debería salir del sistema convertida en acciones concretas: un asiento contable con la imputación correcta, un pago programado dentro de las condiciones acordadas, un estado que el proveedor pueda consultar y una partida presupuestaria actualizada. Si el resultado es un CSV que alguien vuelve a ingresar, la automatización trasladó el ingreso manual en lugar de eliminarlo.
Qué falla, para que puedas preverlo
Notas de crédito que parecen facturas. Varias monedas y redondeos. Anotaciones manuscritas en páginas escaneadas. Proveedores que envían dos veces la misma factura, con pequeñas diferencias cada vez. Los datos bancarios de un proveedor «actualizados» por correo: esa es la excepción que siempre debe llegar a una persona, porque así es como funciona el fraude con facturas.
Ninguno de estos casos es una razón para no automatizar. Son la lista de lo que las reglas de derivación deben detectar desde el primer día.
Qué medir
La tasa de procesamiento sin intervención: la proporción de facturas que ninguna persona tocó. La tasa de excepciones y cuáles fueron esas excepciones. Los días desde la recepción hasta la aprobación. Los duplicados y las discrepancias detectados antes del pago. Las primeras tres métricas deberían cambiar en el primer mes; la cuarta es la que preguntará el director financiero.
Si las facturas son uno de los varios procesos en los que sospechas que la IA debería hacer más, la pregunta real es cuál construir primero y qué permiten tus datos. Vale la pena responderla antes de que alguien escriba una línea de código.
Qué aprendimos al crear el prototipo
Lo construimos como una prueba de concepto, no para un cliente: un tablero de OCR con la factura original de un lado y los campos extraídos del otro —número de factura, fechas, vendedor y comprador con sus identificadores fiscales, conceptos y totales—, además de un conteo de procesadas y pendientes y el JSON sin procesar a un clic. La captura muestra la extracción; la validación y la derivación descritas antes son el diseño que un sistema de producción necesita sobre esa base y no formaron parte del prototipo.
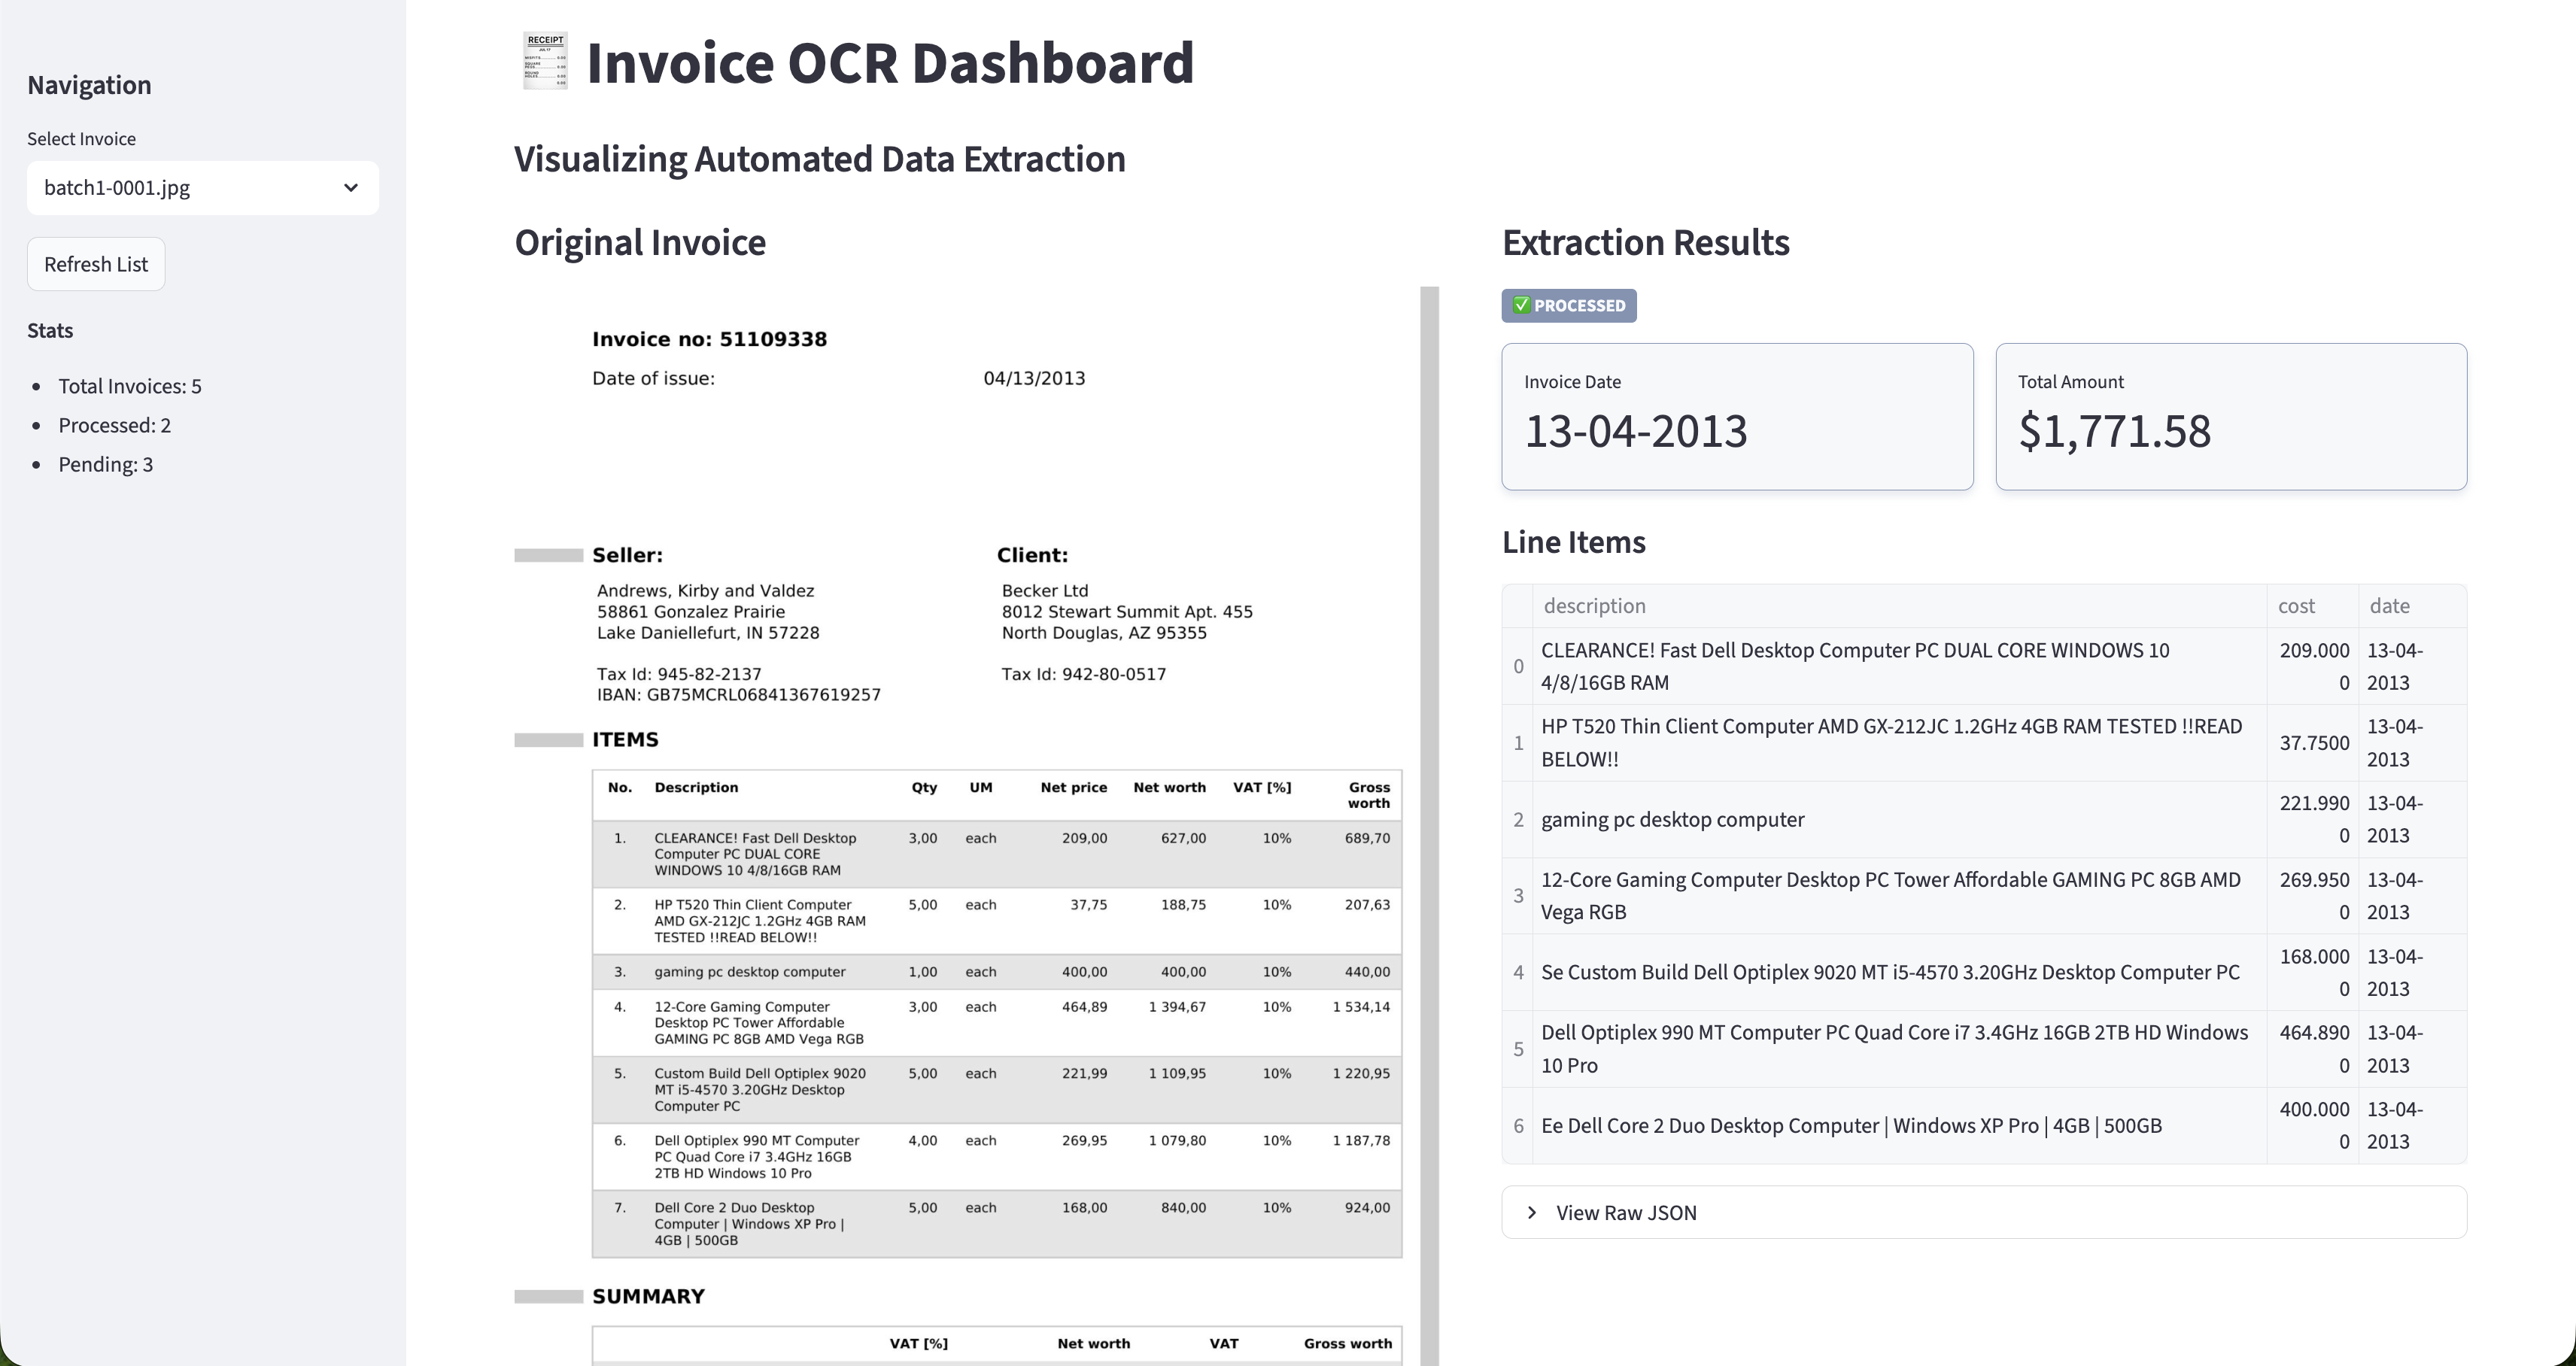
Dos cosas funcionaron con facturas reales. La pantalla con el documento y los campos uno al lado del otro importó más que el modelo: los revisores cotejan la extracción con el documento, no de forma abstracta, y esa es la interfaz que realmente usará un equipo de finanzas. Además, la extracción por sí sola, por buena que sea, deja pendiente la validación: ese es el argumento de todo este artículo. El prototipo demostró la lectura; la validación es el producto.