Predecir la fusión de pull requests de Node.js con aprendizaje automático

En este artículo explicaré un uso sencillo del aprendizaje automático (ML) para evaluar si puede predecirse con precisión la aceptación de un pull request (PR) al crearlo. El experimento busca generar un programa fiable que ayude al integrador a gestionarlos en un proyecto. Como los proyectos grandes reciben PR continuamente, exploramos un modelo replicable para filtrar cuanto antes los no deseados.
Los trabajos de Yu et al.1 y Gousios et al.2 proponen modelos entrenados con varios repositorios para predecir la aceptación incluso en proyectos distintos. Esto reduce la exactitud, especialmente si se entrena con proyectos A y B y se predice en C, cuyos criterios pueden ser diferentes. Nuestro enfoque usa solo datos del mismo proyecto. Predecimos PR de Nodejs con datos disponibles al enviarlos para evaluar inmediatamente si se fusionarán.
Construir el predictor
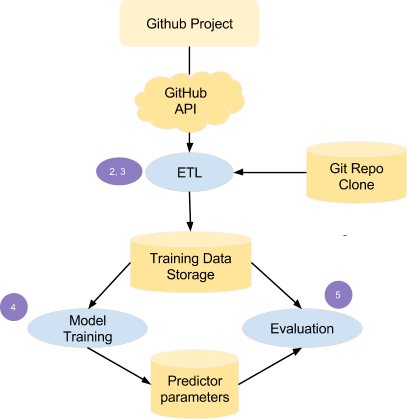
Debemos crear un predictor y encontrar los parámetros adecuados. Seguimos estos pasos:
- Definir características relevantes para evaluar un PR.
- Recopilar datos de las fuentes de GitHub del proyecto.
- Normalizar los datos en un almacén persistente para los modelos ML.
- Elegir el modelo que mejor funcione con los datos.
- Evaluar el predictor en un conjunto separado.
Definir características
En el paso 1 nos basamos en Yu et al. y usamos estas características:
description_complexity
|
Número de palabras en la descripción y el título. Una descripción más larga puede indicar un PR complejo con muchas funciones, más difícil de aprobar. |
log_hotness
|
Se refiere al número H de actividad del área del proyecto: archivos modificados en los últimos 3 meses que también están en el PR. Toma el valor log(1 + H). Una mayor actividad puede indicar demasiados PR que afectan archivos centrales y generan controversia.
|
log_churn
|
Se refiere al volumen de cambios del PR C: suma de líneas eliminadas, modificadas y añadidas. Toma el valor log(1 + H).
|
is_integrator
|
Indica si el autor es integrador: alguien que fusionó un PR al menos una vez en la historia del proyecto. Es más probable que sus PR tengan éxito. Vale 1 o 0 según sea integrador. |
has_tests
|
Indica si el PR incluye pruebas, lo que puede favorecer su aprobación. Vale 1 o 0 según tenga pruebas. Se determina comparando el nombre de cada archivo añadido o modificado con expresiones regulares para identificar pruebas. |
success_rate
|
Número relacionado con la aceptación previa de los PR del autor: proporción entre aprobados y enviados. Una tasa mayor puede indicar aceptación. |
social_conn
|
Suma de seguidores y seguidos del autor. Más conexiones sociales pueden indicar mayor éxito. |
requested_reviewers
|
Indica si el autor solicitó revisores. Sugiere interés en la aceptación del PR. Incluir un revisor puede aumentar la probabilidad de aceptación. |
created_friday
|
Las solicitudes creadas el viernes tienen más probabilidades de no aceptarse o aceptarse más tarde por el fin de semana, aumentando la cola de PR. |
En el futuro podríamos incluir cumplimiento de requisitos de mensajes de commit, pruebas unitarias superadas o cantidad de PR abiertos. También datos cronológicos: los requisitos cambian y un PR antiguo se evalúa con estándares distintos. Clasificar datos temporales es un problema común en ML porque los criterios dependen de cuándo se crearon y clasificaron. Brownlee3 muestra una forma de abordar pronósticos.
Carga ETL
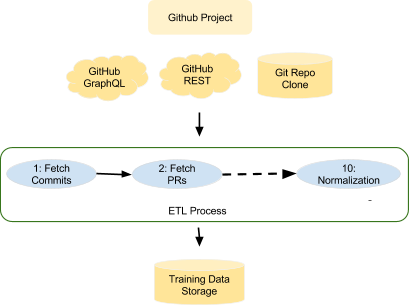
Diagrama del proceso ETL
Los pasos 2 y 3 usan extracción, transformación y carga (ETL), que consume la API de GitHub REST (V3), tanto REST como GraphQL, y guarda características en MongoDB. Recupera datos de los PR mediante la API. Para calcular volumen de cambios y actividad usamos un clon del repositorio y un cliente git para comparar ramas de origen y destino. La API GraphQL (V4) obtiene información de usuarios, incluidas conexiones sociales (social_conn). Permite consultas más ricas entre entidades, como las conexiones de todos los autores, y reduce solicitudes URL. Este código obtiene datos paginados de MergedEvents de un PR para detectar si se fusionó.
{
 repository(owner: nodejs, name: node){
   name,
   pullRequests(first: 100, states: MERGED) {
     nodes {
       id,
       url,
       timeline(last: 100) {
         nodes {
             ... on MergedEvent {
            id,
             actor {
               login
             }
             createdAt,
             url,
           }
         }
       }
     },
     pageInfo {
       hasNextPage,
       hasPreviousPage,
       endCursor,
       startCursor,
     },
     totalCount
   }
  }
}
No pudimos usar GraphQL en todos los casos por límites de solicitudes más bajos que ralentizan la recuperación. Las llamadas complejas también fueron más lentas que sus equivalentes V3. Diseñamos ETL para reanudarse y reiniciarse, pues puede tardar horas. Lo dividimos en estas tareas:
| 1 | fetchCommits
|
Obtiene todos los commits de la rama master mediante la API REST |
| 2 | fetchPullRequests
|
Obtiene los metadatos de todos los PR mediante la API REST |
| 3 | fetchCommitDiffs
|
Clona localmente el repositorio git y las ramas de origen de los PR para calcular actividad y volumen de cambios |
| 4 | fetchUserEvents
|
Guarda los eventos recientes del usuario para calcular conexiones sociales. No se usó en el conjunto final de características. |
| 5 | fetchUserInfo
|
Obtiene metadatos de usuario mediante la API GraphQL |
| 6 | fetchIntegrators
|
Obtiene los integradores consultando MergedEvents del pull request |
| 7 | computeHotness
|
Usa el repositorio local para comparar las ramas de origen y destino del PR y calcular |
| 8 | guessCommitPRRefs
|
Deduce eventos de fusión mediante el historial. Es específico de NodeJS, que cierra PR y los fusiona en un commit separado en lugar de usar la función de GitHub. |
| 9 | setUsersId
|
Decodifica información de usuario en base64 para relacionar datos de PR y usuarios. |
| 10 | Normalization
|
Combina los datos para generar información lista para entrenar: una tabla de características y clasificación (fusionado/no fusionado) |
Tareas ETL para cargar y normalizar datos
Construcción y evaluación del predictor
Sobreajuste de precedentes electorales (fuente: XKCD)
Con los datos listos, los pasos 4 y 5 usan scikit-learn. Para evitar sobreajuste, dividimos en entrenamiento y validación: 90% de los PR para entrenar y 10% para validar. Hacemos validación cruzada dividiendo el entrenamiento en 10 grupos con k-fold. Probamos estos predictores:
- Naive Bayes (Bernoulli y gaussiano)
- Árboles de decisión
- K vecinos más cercanos
- Análisis discriminante lineal
- Regresión logística
- Perceptrones multicapa
- Centroides más cercanos
- Análisis discriminante cuadrático
- Regresión Ridge
- Máquinas de vectores de soporte (SVC), con soporte C y lineales
- Descenso de gradiente estocástico (SGD)
- Algoritmos pasivo-agresivos
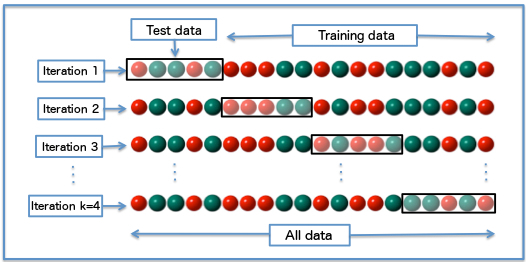
Diagrama de validación k-fold con 4 grupos (fuente: Wikipedia)

Recopilamos 10,200 PR del repositorio nodejs entre noviembre de 2014 y noviembre de 2017. Los datos brutos tenían esta forma. Cerca del 76% de los MR recuperados se fusionaron; es un conjunto considerable para entrenar la mayoría de los predictores.
created_
friday
|
description_
complexity
|
log_hotness
|
log_churn
|
is_integrator
|
|
| Media | 0.172 |
134.500 |
1.147 |
5.944 |
0.498 |
| Desv. estándar | 0.377 |
389.832 |
0.915 |
3.901 |
0.500 |
| Mín. | 0.000 |
1.000 |
0.000 |
0.000 |
0.000 |
| Máx. | 1.000 |
19,825.000 |
4.043 |
15.523 |
1.000 |
| Análisis de datos de PR | |||||||
has_tests
|
success_rate
|
social_conn
|
requested_review
|
was_merged
|
|||
| Media | 0.721 |
0.514 |
4.973 |
0.019 |
0.758 |
||
| Desv. estándar | 0.448 |
0.221 |
1.801 |
0.138 |
0.428 |
||
| Mín. | 0.000 |
0.000 |
0.000 |
0.000 |
0.000 |
||
| Máx. | 1.000 |
1.000 |
11.823 |
1.000 |
1.000 |
||
Probamos 21 clasificadores y obtuvimos exactitud del 77% al 88% en entrenamiento. Elegimos SVC con soporte C, con una media del 87% en 10 validaciones cruzadas. Es bueno para entrenamiento, pero la evaluación real usa datos de prueba. Allí alcanzó una precisión algo menor, del 78%, todavía aceptable.
| Precisión | Exhaustividad | Puntuación F1 | Soporte | |
| No fusionado | 0.76 |
0.22 |
0.34 |
264 |
| Fusionado | 0.78 |
0.98 |
0.87 |
753 |
| Promedio | 0.78 |
0.78 |
0.73 |
1017 |
Métricas de precisión sobre datos de prueba
Conclusiones y mejoras futuras
Los experimentos muestran que podemos predecir MR con exactitud y aliviar la carga de integradores ante grandes colas. Los datos temporales necesitan tratamiento especial: los criterios cambian y quizá convenga filtrar MR antiguos. Más características mejorarán las predicciones. Extraer datos de GitHub puede llevar mucho tiempo y requiere manejar desconexiones y límites de API para recuperar el proceso. Cada proyecto también tiene mecanismos de fusión distintos, a veces sin la función «merge» de GitHub, y puede exigir CI para aceptar un MR. Hay que considerarlo. No hay una solución universal, pero con las herramientas adecuadas puede crearse una aplicación predictora para cada proyecto con suficientes MR. El código está en https://github.com/sophilabs/pullreq-ml.
Referencias
-
Y. Yu, H. Wang, V. Filkov, P. Devanbu y B. Vasilescu, «Espera: factores de latencia en la evaluación de pull requests en GitHub», 2015 IEEE/ACM 12th Working Conference on Mining Software Repositories, Florencia, 2015, pp. 367-371. ↩
-
Gousios, Georgios y Pinzger, Martin y Deursen, Arie van, «Estudio exploratorio del modelo de desarrollo de software basado en pull requests», Proceedings of the 36th International Conference on Software Engineering, pp. 345-355 ↩
-
Jason Brownlee, Cómo convertir una serie temporal en un problema de aprendizaje supervisado en Python, consultado en machinemastery.com, 8 de mayo de 2017. ↩